
Qué es un company brain: tipos y cómo funciona
Qué es un company brain, qué enfoques existen y cómo conecta documentos, decisiones y herramientas para dar contexto a los agentes de IA.
¿Podemos preguntarle a un asistente por qué descartamos una integración hace meses y saber si esa decisión sigue vigente? Tenemos la documentación en Notion, la discusión en Slack y el cambio posterior en Jira. Un company brain intenta hacer consultable ese conocimiento sin obligarnos a reconstruir el contexto en cada conversación.
Yo empezaría por esa pregunta antes de elegir una base de datos vectorial. Encontrar «no vamos a hacerlo» sirve de poco sin el motivo y lo que ocurrió después.
¿Qué es un company brain?
Un company brain es una capa de conocimiento organizacional que reúne información de distintas fuentes y la pone a disposición de personas y asistentes de IA. En un diseño útil, conserva su procedencia, permite actualizarla y controla quién puede consultarla.
El nombre no describe una arquitectura única. OrgLogic lo utiliza para una capa compartida que recupera conocimiento con referencias y controles de acceso; el producto Company Brain enfatiza la extracción de hechos, su revisión y la entrega de ese conocimiento a clientes de IA. Son alcances distintos bajo una etiqueta parecida. [1] [2]
Me interesa separar interfaz e infraestructura: el conocimiento debería seguir disponible aunque cambiemos el chat o el modelo que redacta las respuestas.
Una wiki puede ser una fuente excelente, un buscador resolver la recuperación y un chat con PDFs cubrir un corpus pequeño. Hay que mirar qué añade el company brain en sincronización, contexto compartido y gobierno del conocimiento.
Tampoco basta con guardar conversaciones. El historial conserva lo que se dijo, incluida información provisional y errores. Convertirlo en memoria compartida requiere decidir qué merece conservarse y con qué alcance.
Tipos de company brain: enfoques que podemos combinar
Podemos comparar los company brains por cómo representan y utilizan el conocimiento. Esta clasificación es orientativa, no una taxonomía oficial.
Conocimiento centrado en documentos
El sistema busca en manuales, tickets o conversaciones y entrega al modelo los fragmentos relevantes. Si preguntamos cómo se despliega un servicio, recupera el procedimiento y redacta una respuesta con su referencia.
Permite arrancar sin modelar cada dato del negocio, pero recuperar texto parecido a la pregunta puede dejar fuera el mensaje que cambió una decisión.
Memoria estructurada de hechos y decisiones
Aquí guardamos afirmaciones explícitas: qué se decidió, quién lo aprobó, a qué proyecto afecta y qué fuente lo respalda. Una decisión puede tener un estado vigente o haber sido sustituida por otra.
Company Brain documenta un flujo de propuestas extraídas, revisión y hechos versionados con evidencia. [2] La ventaja de ese diseño es consultar una decisión directamente; el coste está en mantenerla. Si un LLM extrae mal el motivo de un cambio y lo guardamos sin comprobarlo, hemos convertido una interpretación incorrecta en conocimiento persistente.
Conocimiento conectado a herramientas
El asistente puede consultar sistemas en directo y, si está autorizado, ejecutar acciones. Una herramienta es una función que la aplicación ofrece al modelo: leer una incidencia, consultar un pedido o crear una tarea.
Esto permite combinar la explicación histórica con el estado actual del sistema. También introduce otra frontera: saber que una tarea debe abrirse no implica tener permiso para abrirla. La autorización de cada acción pertenece al backend.
| Enfoque | Qué recuperamos | Cuándo aporta valor | Trabajo adicional |
|---|---|---|---|
| Documental | Fragmentos de fuentes | Preguntas sobre procedimientos y documentación | Sincronizar e indexar bien |
| Memoria estructurada | Hechos y decisiones con procedencia | Consultas sobre acuerdos, responsables o vigencia | Validar extracciones y gestionar cambios |
| Con herramientas | Datos actuales y resultados de funciones | Tareas que requieren consultar o modificar otros sistemas | Permisos de ejecución, validación y registro |
Podemos combinar estos enfoques. Su alcance es otra dimensión: empresa, departamento o proyecto. Que sea sectorial describe su dominio, no su tecnología.
Cómo funciona: de las fuentes a la respuesta
El flujo de un company brain conecta fuentes, prepara el conocimiento y recupera una selección autorizada para cada consulta. No exige reentrenar el modelo ni volcar todos los datos al prompt.
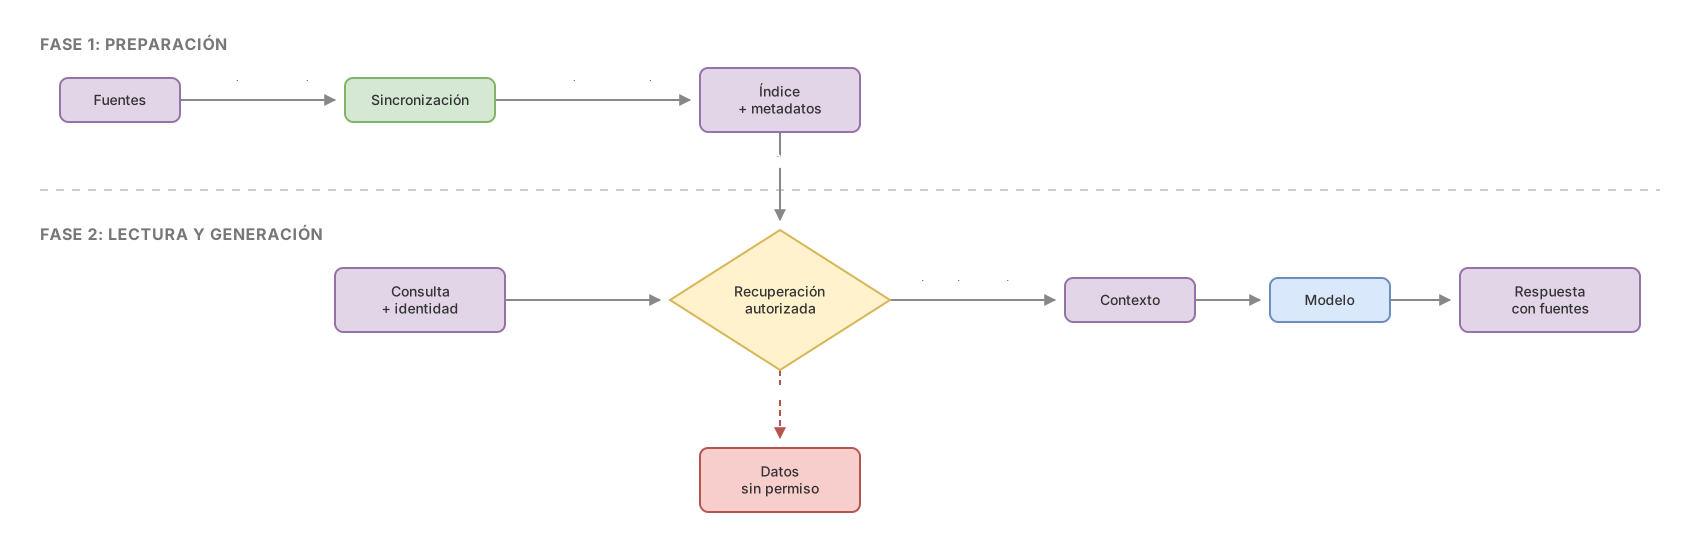
Retomemos la integración descartada: necesitamos recuperar la decisión original y cualquier cambio posterior.
Ingesta y sincronización
Los conectores leen los sistemas de origen. La ingesta transforma su contenido en registros consultables, conservando identificadores, fechas y permisos. Un documento editado debe actualizarse; uno eliminado necesita dejar de aparecer donde corresponda.
Podemos mantener un índice local, consultar algunas fuentes en directo o combinar ambas opciones. Indexar reduce la dependencia de la API de origen durante la consulta, pero añade mantenimiento y un posible retraso de sincronización. Leer en directo evita una copia desactualizada en esa operación, aunque dependemos de la disponibilidad y los límites de la API.
Organización e indexación
El texto puede dividirse en fragmentos y buscarse por palabras o por significado. Los embeddings son representaciones numéricas que permiten comparar similitud semántica, por ejemplo entre «descartamos esta integración» y «motivos para no conectar el proveedor».
También necesitamos metadatos. El proyecto, la fecha y el tipo de documento ayudan a distinguir una decisión aprobada de una propuesta. Un resultado muy parecido a la pregunta sigue pudiendo pertenecer al cliente equivocado.
Recuperación autorizada
La consulta debe ejecutarse con la identidad y el alcance del usuario. Glean, por ejemplo, documenta que los resultados dependen de los permisos de acceso a las aplicaciones conectadas. [3]
La información no autorizada debe quedar fuera antes de llegar al modelo. Pedirle después que oculte un fragmento privado ya implica haberlo entregado. Esta regla afecta también a los resúmenes: derivar conocimiento de un documento restringido no lo convierte en público.
En nuestro ejemplo, recuperamos la decisión del proyecto correcto y buscamos señales de que ha sido sustituida. Si encontramos fuentes contradictorias sin una resolución explícita, la respuesta debería reflejarlo.
Contexto y respuesta
La aplicación entrega al LLM la pregunta y las evidencias. Ese contexto es la información que recibe para responder; la memoria persistente vive fuera.
Esta selección es context engineering: decidir qué necesita ver el modelo en el siguiente paso. Más documentos significan más tokens, coste y material que ordenar, así que incluirlos todos por precaución tiene consecuencias.
La respuesta debería permitir abrir la fuente y comprobar su fecha. Citar un documento ayuda a verificarla, pero no garantiza que el modelo lo haya interpretado bien. Y si no encontramos la decisión, «no hay evidencia suficiente» es una salida válida.
Qué papel tienen RAG, los grafos y MCP
RAG, los grafos de conocimiento y MCP resuelven problemas distintos dentro de un company brain; no son requisitos que debamos acumular para poder usar ese nombre.
RAG, retrieval-augmented generation, combina recuperación de información y generación de texto. El trabajo original de Lewis y sus coautores combina un modelo con una memoria externa recuperable. [4] En una aplicación empresarial podemos usar esa idea para buscar evidencia antes de responder; el pipeline de RAG empresarial desarrolla sus piezas.
Un grafo representa entidades y relaciones: qué servicio afecta una decisión o de qué proveedor depende. Ayuda cuando necesitamos consultar esas conexiones; si bastan documentos y filtros, añade extracción y mantenimiento que tendremos que justificar.
MCP, Model Context Protocol, permite que aplicaciones de IA accedan a recursos y herramientas mediante una interfaz común. Su documentación separa el intercambio de contexto de la forma en que la aplicación utiliza el LLM. [5] Podemos exponer una consulta de conocimiento por MCP o por una API convencional; el protocolo no decide qué fuente es fiable ni sustituye nuestros permisos.
Cómo se están aplicando los company brains
En ingeniería, podemos consultar el motivo de una decisión de arquitectura junto a sus incidencias. En soporte, recuperar el procedimiento aprobado y consultar el estado actual de una cuenta. En gestión de proyectos, reconstruir acuerdos y cambios de alcance con sus fuentes. Son casos distintos, así que la misma configuración de recuperación no tiene por qué servir para todos.
También aparecen aplicaciones por industria. EVA Brain, de Sinapser, es un ejemplo de company brain para la gestión de eventos: su propuesta pública reúne conocimiento de proyectos y decisiones, con referencias a las fuentes y permisos por proyecto y persona. Ilustra cómo especializar esta capa alrededor del vocabulario y el trabajo de un sector, sin que el concepto general dependa de ese sector.
Dónde falla una memoria empresarial
Una memoria empresarial falla cuando devuelve información incorrecta, obsoleta o fuera de los permisos de quien consulta. El modelo puede redactar bien en cualquiera de esos casos.
Confundir lo reciente con lo vigente
El mensaje más nuevo puede ser una sugerencia, mientras que el documento anterior contiene el acuerdo aprobado. La fecha sirve para ordenar, pero necesitamos distinguir propuestas de decisiones. Para comprobarlo, usaría una consulta donde una discusión posterior no modifica el acuerdo y otra donde sí lo sustituye.
Guardar conclusiones sin procedencia
Un resumen que afirma «el proveedor fue descartado por coste» debe permitir volver al fragmento que lo respalda. Sin esa conexión cuesta corregirlo y sabemos menos de lo que parece: quizá el coste era una hipótesis del resumen, no el motivo acordado.
Convertir documentos en instrucciones
Una fuente puede contener texto que intente cambiar el comportamiento del asistente. OWASP describe esta prompt injection indirecta en archivos y otras fuentes externas. [6] Separar contenido e instrucciones ayuda, pero no da una garantía completa. Los controles de acceso y las restricciones de las herramientas deben seguir funcionando aunque el modelo interprete mal ese texto.
Evaluar solo respuestas cómodas
Preguntar por el nombre de un producto demuestra poco. Antes de ampliar el sistema, comprobaría decisiones sustituidas, fuentes contradictorias, consultas sin respuesta y accesos revocados. Además de la respuesta, registraría qué se recuperó, con qué permisos y cuántos tokens se enviaron. Así podemos distinguir un fallo de búsqueda de uno de interpretación.
Por dónde empezaría a construirlo
Empezaría con un proyecto acotado, fuentes identificadas y consultas reales que hoy obligan a buscar a mano. Primero resolvería recuperación, actualización y permisos; incorporaría memoria estructurada cuando necesitásemos consultar decisiones explícitas.
Las acciones pueden esperar hasta que leer funcione bien. La arquitectura de un agente empresarial añade las piezas para pasar de responder a ejecutar, con fronteras que conviene mantener claras.
Mi criterio para elegir complejidad sería muy concreto: ¿podemos recuperar aquella decisión, comprobar por qué se tomó y detectar que ya no aplica? Si todavía no podemos, añadir más conectores solo nos da más sitios donde equivocarnos.
Fuentes
- Company Brain de OrgLogic: uso del término para una capa compartida de conocimiento con fuentes y control de acceso.
- Documentación de Company Brain: extracción de propuestas, revisión y hechos versionados con evidencia.
- Cómo accede Glean a la información: recuperación condicionada por los permisos en las fuentes conectadas.
- Retrieval-Augmented Generation, Lewis et al.: combinación de generación y recuperación desde una memoria externa.
- Arquitectura de MCP: intercambio de contexto mediante recursos y herramientas, independiente de la gestión del LLM.
- Prompt Injection, OWASP: inyección indirecta y medidas para limitar sus efectos.
Preguntas Frecuentes
¿Un company brain necesita entrenar un modelo propio?
No. Podemos mantener el conocimiento fuera del modelo y recuperar la información necesaria en cada consulta. Reentrenar es una decisión distinta y no resuelve por sí solo la actualización de fuentes ni los permisos.
¿Qué diferencia hay entre un company brain y RAG?
RAG es una técnica que combina recuperación y generación. Company brain es una etiqueta más amplia para un sistema de conocimiento organizacional, que puede usar RAG y añadir sincronización, memoria estructurada o integración con herramientas.
¿Puede consultar todos los datos de la empresa?
Solo debería consultar las fuentes conectadas y autorizadas para esa persona o agente. Tener un índice compartido no justifica devolver el mismo contenido a todo el mundo.
¿Hace falta un grafo de conocimiento?
No. Tiene sentido cuando necesitamos representar y recorrer relaciones que la recuperación documental no resuelve bien. Para un primer conjunto de preguntas sobre documentación, puede bastar con búsqueda y metadatos.
Artículos relacionados
Context engineering: la habilidad que sustituyó al prompt engineering
Context engineering es gobernar qué ve el modelo en cada paso, no pulir el prompt. Técnicas, coste del cache y compromisos, con datos verificados.
RAG empresarial: el pipeline completo que realmente funciona
Cómo construir un RAG de producción con chunking semántico, hybrid search y reranking. Las decisiones reales que determinan si tu sistema recupera bien o falla en silencio.
Arquitectura de un agente empresarial: las 6 decisiones que importan
Las 6 decisiones de arquitectura para tu primer agente IA en producción: objetivo preciso, memoria, herramientas con mínimo privilegio y supervisión humana.