
MCP vs RAG: diferencias y cómo funcionan juntos
MCP conecta el modelo con herramientas y datos en vivo. RAG le mete texto relevante en el prompt. No compiten: aquí está la diferencia y cuándo usar los dos.
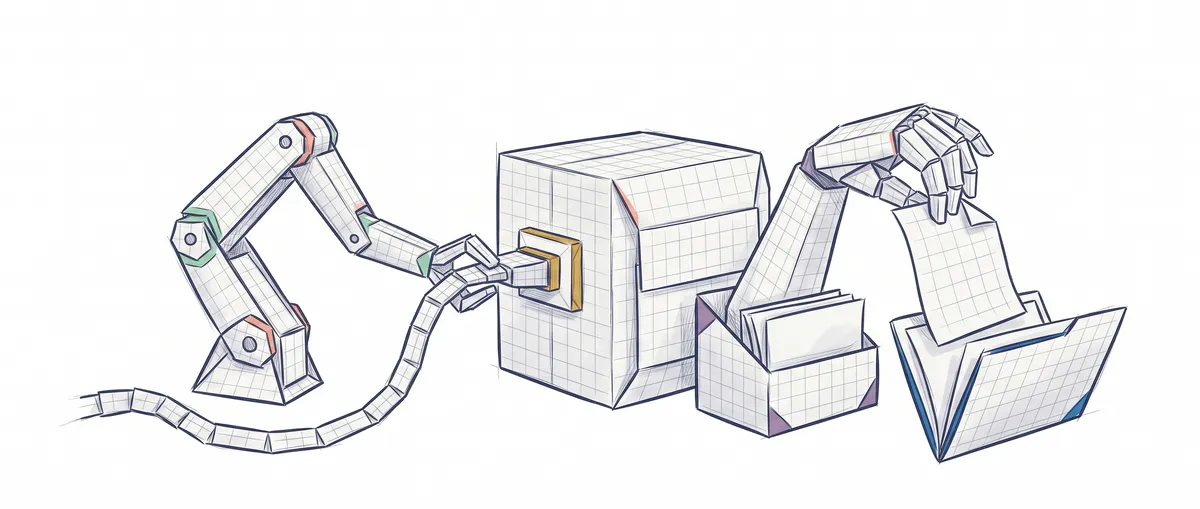
MCP es un protocolo para conectar un modelo con herramientas y datos en vivo. RAG es una técnica para buscar texto relevante y meterlo en el prompt antes de que el modelo responda. No compiten: resuelven problemas distintos y en un sistema real suelen convivir.
Las dos siglas aparecen en la misma conversación porque las dos suenan a lo mismo, “darle a la IA datos que no vio durante su entrenamiento”. Da igual si lo buscas como MCP vs RAG o como RAG vs MCP: la duda práctica no es cuál es mejor, es cuál de los dos te falta ahora mismo. Si vienes sin contexto previo, tengo un artículo sobre qué es MCP y cómo conecta un modelo con herramientas y otro sobre qué es RAG y para qué sirve.
MCP vs RAG, lado a lado
| MCP | RAG | |
|---|---|---|
| Qué es | Un protocolo abierto, publicado por Anthropic en noviembre de 2024, montado sobre JSON-RPC, un formato de mensajes que ya existía | Una técnica de recuperación de información, descrita por Lewis et al. en NeurIPS 2020 |
| Qué problema resuelve | El modelo no puede tocar tus sistemas | El modelo no ha leído tus documentos |
| Qué le añade al modelo | Capacidad de actuar y de consultar datos vivos | Conocimiento: fragmentos de texto dentro del prompt |
| Cuándo ocurre | Mientras el agente corre: el cliente pide el catálogo de herramientas, el modelo elige una y la llama | Antes de generar: se busca en un índice y lo encontrado se pega al prompt |
| Qué tienes que montar | Un servidor que publique herramientas con su nombre, su descripción y su inputSchema | Un índice sobre tus documentos, más el código que busca y arma el prompt |
| Si el dato cambia | La siguiente llamada devuelve ya el valor nuevo | Hay que volver a indexar ese documento, o el modelo seguirá citando lo viejo |
| Quién lo consume | Cualquier cliente compatible con el protocolo, no solo el tuyo | Tu aplicación, que es la que arma el prompt |
La fila de “si el dato cambia” es la que decide casi todo. Un índice es una foto del pasado, y una herramienta es una pregunta al presente.
Cuándo usar MCP o RAG
Imagina una tienda online con su manual interno y una base de datos de pedidos.
Si la pregunta es “¿cuántos días tenemos para aceptar una devolución?”, la respuesta ya está escrita en un documento. Buscas los fragmentos que hablan de devoluciones, los metes en el prompt y el modelo redacta la respuesta con ellos delante. Eso es RAG, y el pipeline completo de ingesta e indexado está en la guía de RAG empresarial.
Si la pregunta es “¿en qué estado está el pedido 4821?”, no hay ningún documento que la conteste. El dato vive en una base de datos y cambia varias veces al día. Aquí lo que necesitas es que el modelo pueda hacer tool calling, o sea pedir que se ejecute una herramienta en vez de intentar contestar de memoria (cómo un LLM accede a herramientas externas), y MCP es el protocolo abierto que estandariza cómo se describe esa herramienta y cómo se ejecuta, sea cual sea el cliente.
Un matiz que se pierde con la versión simplificada de “RAG lee, MCP actúa”: un servidor MCP también expone recursos de solo lectura, identificados por una URI (una dirección como file:///manual.pdf), además de herramientas. La frontera real pasa por otro sitio: texto congelado en un índice frente a una consulta que se resuelve en el momento.
Cómo se combinan en el mismo agente
Como son capas distintas, puedes montar la búsqueda RAG dentro de una herramienta MCP.
// Una herramienta MCP cuyo cuerpo, por dentro, hace RAG
server.registerTool(
  "buscar_en_manual",
  {
    // El modelo lee esta descripción para decidir si llamarla
    description: "Busca en el manual interno y devuelve los fragmentos relevantes",
    inputSchema: z.object({ pregunta: z.string() }),
  },
  async ({ pregunta }) => {
    // Esto es RAG: buscar los fragmentos que más se parecen a la pregunta
    const fragmentos = await indice.buscar(pregunta, { top: 5 });
    // El texto vuelve al contexto del modelo
    return { content: [{ type: "text", text: fragmentos.join("\n\n") }] };
  },
);
El modelo no sabe que ahí dentro hay un índice de documentos. Ve una herramienta con un nombre y una descripción, igual que ve consultar_pedido. Y al índice le da igual quién le pregunta. Cada capa hace su trabajo sin conocer a la otra, que es justo lo que quieres cuando mañana cambies el índice y no quieras tocar el agente.
Esa separación es la que convierte un chat que responde preguntas en un agente que resuelve tareas, y es el patrón que trabajamos paso a paso en el curso de patrones agénticos.
Preguntas Frecuentes
¿Cuál es la diferencia entre MCP y RAG?
MCP es un protocolo de conexión y RAG es una técnica de recuperación. MCP define cómo el modelo descubre y llama a algo que vive fuera de él; RAG decide qué texto acaba dentro del prompt antes de que el modelo escriba una sola palabra. Uno es la fontanería, el otro es qué le das a leer.
¿MCP sustituye a RAG?
No, y el intento se nota rápido en cuanto lo pruebas. Si contestas “¿cuántos días tenemos para aceptar una devolución?” con una llamada a herramienta, acabas escribiendo una herramienta por cada pregunta que se le pueda ocurrir a un cliente. Y si haces lo contrario, indexar la tabla de pedidos para ahorrarte la herramienta, el modelo te citará tan tranquilo el estado que tenía el pedido el día que indexaste.
¿Puedo usar MCP y RAG a la vez?
Sí, y la frontera es más concreta de lo que parece: pasa por dentro de la función que ejecuta la herramienta. El servidor MCP publica hacia fuera el nombre, la descripción y el inputSchema; lo que ocurra dentro de esa función, sea una consulta SQL o una búsqueda en un índice, es asunto tuyo y el modelo no lo ve nunca.
¿MCP es lo mismo que function calling?
No: function calling es el mecanismo por el que un modelo pide ejecutar una función, y MCP es el protocolo que estandariza cómo se publica y se descubre ese catálogo de herramientas. Ese eje lo desarrollo en MCP vs API.
Si ya tengo MCP montado, ¿necesito RAG?
Depende de dónde vive la respuesta. Para datos estructurados que consultas por identificador, no: una herramienta que va a la base de datos suele ser más precisa y más barata que una búsqueda por similitud, que es buscar por parecido de significado y es justo lo que hace RAG. Para preguntas en lenguaje natural sobre un montón de texto sin estructura, sí lo vas a necesitar, aunque lo acabes llamando desde una herramienta MCP.
¿Cuál aprendo primero si estoy empezando?
MCP, porque el retorno es inmediato: conectas un cliente que ya existe a un servidor que ya existe y ves al modelo usar tus herramientas la misma tarde. RAG tiene más piezas propias que montar antes de que funcione nada, y para entender qué falla dentro conviene haber visto ya cómo el modelo consume el contexto.
Artículos relacionados
Qué es MCP: el protocolo que conecta agentes IA con herramientas
MCP (Model Context Protocol) estandariza cómo los agentes de IA se conectan a herramientas externas. Explicación con ejemplos en Python comentados línea a línea.
Qué es RAG en IA: definición simple y para qué sirve
RAG es buscar tus documentos y dárselos al modelo antes de que responda. Qué es, qué problema resuelve, cómo funciona y cuándo no merece la pena.
MCP vs API: diferencias y cuándo usar cada uno
MCP no sustituye a tu API REST: la envuelve para que un agente descubra sus herramientas solo. Comparativa y cuándo usar MCP, API o function calling.