
Prompt chaining vs chain of thought: dentro o entre llamadas
Chain of thought pasa dentro de una llamada al modelo. Prompt chaining, entre varias. Cuál usar, cuándo combinarlas y el mismo ejemplo con las dos.
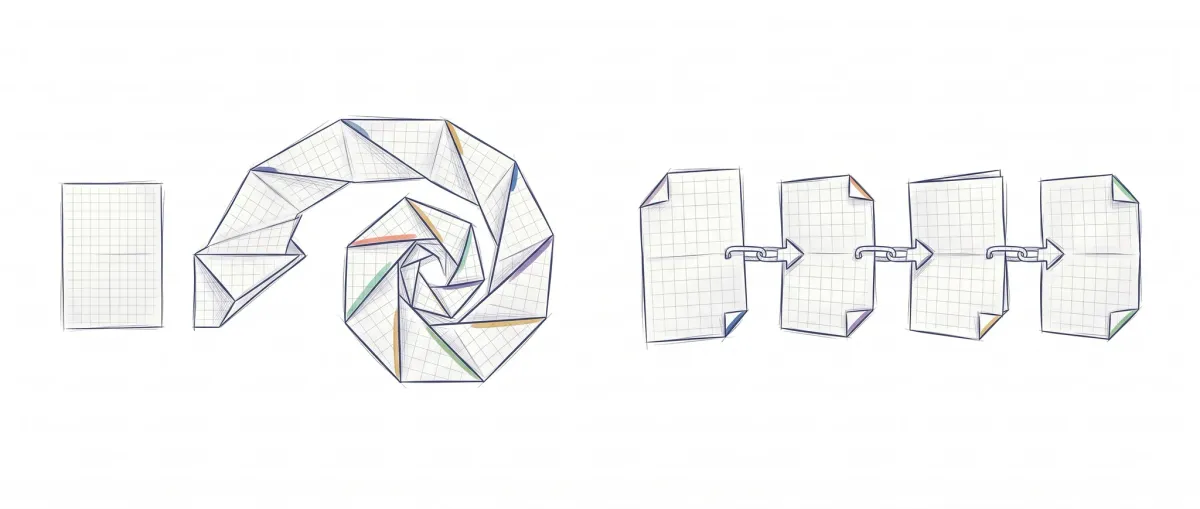
Los dos nombres llevan la palabra “cadena” dentro y por eso los solemos usar como sinónimos, pero resuelven problemas distintos y viven en capas distintas del sistema. Chain of thought pasa dentro de una sola llamada al modelo. Prompt chaining pasa entre varias llamadas. Esa frase resuelve casi toda la confusión, y el resto del artículo es lo que se deduce de ella.
Piénsalo con un compañero de mesa. Chain of thought es pedirle que te explique su razonamiento en voz alta mientras resuelve el problema entero de una sentada: al final te da su respuesta y su explicación, todo junto. Prompt chaining es pedirle una cosa, mirar tú lo que te ha dado, y solo entonces pedirle la siguiente. En el primer caso no puedes interrumpir a mitad. En el segundo, sí.
Para seguir esto solo necesitas saber qué es un LLM (el modelo al que le mandas texto y te devuelve texto) y haber escrito alguna vez un prompt. Nada más.
Prompt chaining vs chain of thought: la diferencia en una tabla
| Chain of thought | Prompt chaining | |
|---|---|---|
| Qué es | Una técnica de prompting: le pides al modelo que razone antes de darte la respuesta | Una técnica de arquitectura: partes la tarea y encadenas llamadas |
| Dónde ocurre | Dentro de una llamada | Entre llamadas |
| Nº de llamadas | Una | Dos o más |
| Dónde vive el estado intermedio | En el contexto de esa llamada, o sea en la memoria de trabajo del modelo | En variables de tu código |
| Qué puedes inspeccionar | El texto final, y el razonamiento solo si el modelo te lo devuelve | La salida de cada paso, antes de pasarla al siguiente |
| Qué puedes validar | Nada a mitad de camino | Cada paso, con un if normal y corriente |
| Si algo sale mal | Repites la llamada entera | Reintentas solo el paso que falló |
| Coste y latencia | Un prompt, una espera | Varios prompts y varias esperas, cada uno más corto |
Dos palabras de la tabla, por si te suenan de oídas. El estado intermedio es el resultado a medias: en el ejemplo de más abajo, la categoría de una incidencia antes de haber redactado la respuesta. La latencia es lo que tarda en volver una llamada al modelo, contada desde que la mandas: dos llamadas cortas suman sus dos esperas, aunque cada una sea más rápida que una larga.
Fíjate en la fila del estado, porque es la que de verdad manda. Todo lo demás viene detrás: si el resultado intermedio está dentro del modelo, tu código no puede verlo, ni comprobarlo, ni corregirlo. Si está en una variable de tu código, puedes hacer con él lo que harías con cualquier otro dato.
El término chain of thought viene de un paper de Jason Wei y su equipo en 2022, donde mostraron que pedirle al modelo los pasos intermedios en vez de solo el resultado mejoraba mucho su rendimiento en problemas de razonamiento [1]. Prompt chaining es otra familia: Anthropic lo define como descomponer una tarea en una secuencia de pasos donde cada llamada procesa la salida de la anterior [2].
El mismo ejemplo con las dos técnicas
Vamos con una tarea concreta: llega una incidencia de soporte escrita en texto libre y quieres dos cosas, clasificarla y redactar una respuesta.
Con chain of thought: una llamada
Aquí le pides al modelo que piense antes de contestar y te devuelva todo junto. Uso el SDK oficial de Anthropic para TypeScript.
import Anthropic from "@anthropic-ai/sdk";

// Creamos el cliente (usa la variable de entorno ANTHROPIC_API_KEY)
const client = new Anthropic();

// El texto de la incidencia. Aquí lo escribo a mano; en tu caso vendrá
// de un formulario, de un email o de la base de datos
const incidencia = "Llevo tres días sin poder entrar y encima me habéis cobrado el mes.";

// La API devuelve una LISTA de bloques (texto, imágenes, otros tipos):
// esta función se queda solo con los de texto y los junta en un string
function texto(res: Anthropic.Message): string {
  return res.content.map((b) => (b.type === "text" ? b.text : "")).join("");
}

const res = await client.messages.create({
  model: "claude-opus-5", // modelo grande: le pedimos razonar y redactar a la vez
  max_tokens: 1024,       // máximo de tokens que puede generar en la respuesta
  // Apagamos el razonamiento propio del modelo para que el paso a paso
  // que veremos sea el que hemos pedido nosotros en el prompt, y no el suyo
  thinking: { type: "disabled" },
  messages: [{ role: "user", content:
    `Incidencia: "${incidencia}"\n` +
    // "Razona paso a paso" es, literalmente, el chain of thought
    `Razona paso a paso y termina con un JSON {categoria, respuesta}.` }],
});

// Todo viene junto en el mismo string: el razonamiento y el JSON
const salida = texto(res);
Esa línea del thinking merece una explicación, porque cambia el sentido del ejemplo. Los modelos de razonamiento actuales piensan por su cuenta antes de responder, y ese razonamiento propio no llega al bloque de texto: viaja aparte y por defecto ni se muestra. Si lo dejamos activado, el “razona paso a paso” del prompt se solapa con algo que el modelo ya estaba haciendo mejor. Apagándolo, el ejemplo enseña el chain of thought manual tal cual se inventó. En un proyecto de verdad, con un modelo de razonamiento harías lo contrario: dejarlo encendido y bajar el esfuerzo.
Una llamada, una espera, y el razonamiento del modelo mezclado con el resultado. Si la categoría sale mal, lo que tienes es un string entero malo: no hay ningún punto donde meter la mano.
Con prompt chaining: dos llamadas
La misma tarea, partida. La primera llamada solo clasifica. Tu código comprueba que la categoría sea una de las que esperas, y solo entonces lanza la segunda. A esa comprobación entre dos pasos se le llama gate: una puerta que la salida tiene que pasar antes de que la cadena siga.
// La lista cerrada de categorías válidas: contra esto vamos a validar
const CATEGORIAS = ["facturacion", "acceso", "bug", "otro"];

// Paso 1: solo clasificar. Devuelve una palabra y nada más.
const paso1 = await client.messages.create({
  model: "claude-haiku-4-5-20251001", // modelo pequeño: este paso es fácil, así sale más rápido y más barato
  max_tokens: 64,                     // con una palabra sobra
  messages: [{ role: "user", content:
    `Clasifica en una sola palabra (${CATEGORIAS.join("|")}): "${incidencia}"` }],
});

// La salida del paso 1 ya es una variable tuya, no algo dentro del modelo
const categoria = texto(paso1).trim().toLowerCase();

// El gate: un if normal y corriente. Si la palabra no está en la lista, no seguimos.
if (!CATEGORIAS.includes(categoria)) throw new Error(`Categoría inválida: ${categoria}`);

// Paso 2: redactar, ya sabiendo de qué tipo es la incidencia
const paso2 = await client.messages.create({
  model: "claude-opus-5", // aquí sí el grande: redactar bien es el trabajo difícil
  max_tokens: 512,
  messages: [{ role: "user", content:
    `Responde a esta incidencia de tipo "${categoria}": "${incidencia}"` }],
});
La diferencia práctica está en esa línea del if. categoria es una variable de tu programa: puedes loguearla, guardarla en base de datos, enseñarla en un panel, reintentar solo el paso 1 si no te convence, o cortar la cadena antes de gastar la segunda llamada. Nada de eso existe en la versión anterior. El paso a paso completo para montar una cadena de verdad, con reintentos y control de errores, lo tienes en la guía de prompt chaining, y si prefieres verlo ya montado sobre un framework hay ejemplos con código.
Cuándo usar cada una, y cuándo las dos
El criterio es corto: usa chain of thought cuando el problema es de razonamiento, y prompt chaining cuando el problema es de fiabilidad.
Chain of thought te sirve para una tarea que el modelo puede hacer de una vez pero se equivoca si contesta a bote pronto: un cálculo con varios pasos, o una decisión que depende de varias condiciones a la vez. No añade ninguna pieza a tu arquitectura, es texto en el prompt.
Prompt chaining te sirve cuando la tarea se parte limpiamente en subtareas y necesitas ver qué pasa por en medio. Anthropic lo resume como un intercambio: pagas más latencia a cambio de más precisión, porque cada llamada tiene un trabajo más fácil [2]. Ese intercambio sale a cuenta cuando un error silencioso te cuesta caro.
Y se combinan sin ningún truco, porque cada paso de una cadena es una llamada normal: dentro de ese paso puedes pedir razonamiento paso a paso igual que en cualquier otro prompt. Cadena por fuera, razonamiento por dentro. Es la configuración que acabas usando en cuanto el flujo tiene más de dos pasos, y montarla con las manos, decidiendo dónde partir y qué validar, es lo que se practica en el curso de patrones agénticos.
Errores comunes
Montar una cadena cuando el problema era de razonamiento
El modelo se equivoca en una tarea que sabe hacer de una vez, y tú respondes partiéndola en cuatro llamadas. Has añadido tres esperas y tres sitios donde se pierde contexto para arreglar algo que se arreglaba con una frase en el prompt. Antes de partir nada, pídele los pasos dentro de la llamada que ya estás haciendo y mira si con eso basta.
Pedir razonamiento paso a paso esperando poder validarlo desde código
El error simétrico. Le pides al modelo que razone, y luego intentas leer esos pasos desde tu programa para comprobar el resultado intermedio. Ese texto es parte de la respuesta, no un dato: cambia de forma cuando le apetece. Si necesitas comprobar un intermedio desde código, ese intermedio tiene que ser la salida de una llamada propia.
Creer que el razonamiento que ves es el razonamiento real
Cuando el modelo escribe “primero comprobé X, luego deduje Y”, eso es texto generado como cualquier otro, no un registro de lo que pasó por dentro. Suele correlacionar con una respuesta mejor, y por eso funciona, pero no lo trates como una traza de ejecución fiable.
Meter todo el razonamiento en el prompt del sistema y olvidarse de la ventana
Cuanto más largo es el prompt y más razonamiento genera el modelo, más ventana de contexto ocupas, que es el espacio limitado donde cabe todo lo que el modelo lee y escribe en una llamada. En una cadena esto se controla solo, porque cada paso arranca con lo justo.
Cómo encajan few-shot y meta prompting
Son las otras dos técnicas que se mezclan con estas dos, y colocarlas en el mismo mapa de capas quita bastante ruido.
Prompt chaining vs few-shot prompting
Few-shot prompting es meter ejemplos ya resueltos dentro del prompt para que el modelo copie el patrón. Few-shot cambia lo que el modelo ve dentro de una llamada; prompt chaining cambia cuántas llamadas hay. Por eso no compiten: few-shot vive en la misma capa que chain of thought, y de hecho se combinan, porque el paper original enseñaba el razonamiento con ejemplos que ya lo traían escrito [1].
Prompt chaining vs meta prompting
Meta prompting es pedirle al modelo que escriba o mejore el prompt que vas a usar después. Meta prompting te da el texto de un prompt, antes de ejecutar nada; prompt chaining decide cuántos prompts se ejecutan y en qué orden, mientras el flujo corre. Lo normal es usar meta prompting para afinar el prompt de un paso concreto de tu cadena. Si quieres el mapa ordenado de todas estas técnicas, lo tienes en los patrones esenciales de prompt engineering.
Checklist para decidir
- ¿El fallo que tengo es de razonamiento (el modelo se lía) o de fiabilidad (unas veces sale bien y otras no)?
- ¿Me basta con pedir razonamiento dentro de la llamada que ya hago?
- ¿Necesito ver el resultado intermedio desde código, para comprobarlo, guardarlo o enseñarlo?
- ¿Puedo permitirme la latencia extra de varias llamadas donde antes había una?
- ¿Sabría decir en qué punto parto la tarea, y por qué justo ahí?
Si de aquí sales con que hay que encadenar, la checklist de implementación (el formato de salida de cada paso, los gates y qué hacer cuando uno falla) está en la guía de prompt chaining.
Fuentes
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models — Wei et al., 2022 — origen del término chain of thought y del uso de ejemplos con razonamiento escrito.
- Building Effective AI Agents — Anthropic — definición de prompt chaining como secuencia de llamadas donde cada una procesa la salida de la anterior, y el intercambio latencia/precisión.
- Prompting best practices — Claude Platform Docs — recomendación de instrucciones generales frente a pasos prescritos con thinking activado, y el chain of thought manual como alternativa cuando está desactivado.
Preguntas Frecuentes
¿Chain of thought sigue haciendo falta con los modelos de razonamiento?
Menos, y de otra forma. Con el razonamiento activado, la documentación de Claude recomienda instrucciones generales como “piensa a fondo” en vez de un plan paso a paso escrito a mano, porque el razonamiento del modelo suele ir más allá de lo que le prescribirías tú [3]. El chain of thought manual queda como alternativa para cuando el razonamiento está desactivado.
¿Puedo usar prompt chaining y chain of thought a la vez?
Sí, y es lo normal en cuanto el flujo crece. Cada paso de la cadena es una llamada independiente, así que dentro de ese paso puedes pedir razonamiento igual que en cualquier prompt suelto. La cadena organiza el flujo por fuera y el razonamiento trabaja por dentro de cada eslabón. Ojo con un matiz: por muchos pasos que encadenes, el orden lo sigues decidiendo tú en tu código; cuando es el modelo el que decide qué hacer a continuación, ya estás hablando de un agente.
¿Cuál gasta más tokens?
Depende de la tarea y no hay una regla fija. Chain of thought gasta tokens de salida en el razonamiento, que en una tarea larga pueden ser muchos. Prompt chaining reparte el trabajo en llamadas más cortas, pero repite instrucciones y contexto en cada una. La forma honesta de saberlo es medir tu caso concreto con los contadores de uso que devuelve la propia API.
¿Few-shot y prompt chaining son alternativas?
No, y elegir entre las dos no tiene sentido. Few-shot prompting mejora una llamada metiéndole ejemplos resueltos; prompt chaining decide cuántas llamadas hay. Puedes poner ejemplos few-shot dentro del paso 1 de tu cadena y no poner ninguno en el paso 2, porque son decisiones de capas distintas.
Artículos relacionados
Prompt Chaining: cómo dividir una tarea compleja en pasos simples
Aprende a dividir tareas difíciles en llamadas LLM secuenciales. Con código TypeScript comentado línea a línea y sin frameworks externos.
Prompt Engineering para desarrolladores: los 5 patrones esenciales
Los 5 patrones de prompt engineering: zero-shot, few-shot, CoT, role prompting y structured output con código TypeScript real.
Encadenamiento de prompts con LangChain: ejemplos con código
Ejemplos de encadenamiento de prompts con LangChain en TypeScript, listos para copiar, y la misma cadena sin framework para comparar. Código completo.