Ingeniería de ingesta para RAG: datos fiables, fuentes y costes
Cómo optimizar la ingesta de datos para RAG: conservar contexto y fuentes, validar extracciones, reanudar cargas y evaluar antes de publicar.
¿Tu buscador encuentra el informe correcto, enlaza la fuente y aun así devuelve una cifra equivocada? La ingesta de datos para RAG puede conservar el número y perder lo que significa. Yo empezaría por comprobar esa transformación antes de cambiar el modelo que responde.
Imaginemos un informe ficticio: «El 35 % de las empresas de más de 500 empleados aumentó su presupuesto de formación en 2025». El buscador responde que las empresas aumentaron ese presupuesto un 35 %. Tiene enlace, pero ha cambiado la población y ha convertido una proporción de empresas en la magnitud del aumento.
RAG, retrieval-augmented generation, combina búsqueda y generación: recuperamos información y se la entregamos a un LLM para responder. Preparar bien esa información reduce algunas causas de alucinación. También permite distinguir un fallo de extracción de uno de búsqueda o interpretación, que requieren arreglos diferentes.
Un dato necesita más que una cifra y una URL
Un dato citable necesita evidencia localizable y contexto suficiente para interpretar su alcance. La URL identifica una fuente, pero no explica qué se midió ni dónde comprobarlo.
Para nuestro informe ficticio, conservaría la frase original, la página, la variable medida, el periodo y la población. Si la muestra o el país no aparecen en la evidencia disponible, quedarían como desconocidos. Un título sobre empresas europeas puede orientarnos, pero no demuestra que cada cifra del documento describa a toda Europa.
Este es un registro ilustrativo, no el contrato de una herramienta concreta:
{
  "id": "dato-001",
  "fuenteId": "informe-ficticio",
  "versionFuente": "2025-v1",
  "paginaPdf": 12,
  "origen": "texto",
  "afirmacion": "El 35 % de las empresas de más de 500 empleados aumentó su presupuesto de formación en 2025.",
  "evidencia": "El 35 % de las empresas de más de 500 empleados aumentó su presupuesto de formación en 2025.",
  "variable": "empresas que aumentaron el presupuesto de formación",
  "valor": 35,
  "unidad": "porcentaje",
  "poblacion": "empresas de más de 500 empleados",
  "periodo": "2025",
  "base": null,
  "ambito": null,
  "aproximado": false
}
El null evita que rellenemos huecos con suposiciones. Conviene registrar también qué comprobaciones se hicieron y con qué versión del extractor, para poder revisar el dato después.
La página debe tener un significado estable: posición dentro del PDF o número impreso. Podemos guardar ambos cuando difieren. Para HTML necesitaremos otro localizador, como una sección o un fragmento identificado, y una copia versionada si queremos reproducir la comprobación.
Esto desarrolla la preparación de conocimiento de un company brain. La transformación debería permitir volver de la respuesta al dato y del dato a la evidencia original, incluso después de actualizar el índice.
Extraer texto, tablas y gráficos sin perder relaciones
La extracción debe conservar las relaciones entre cifras, etiquetas y contexto, además de las palabras del documento. Un PDF convertido a texto puede mezclar columnas, separar una cabecera de sus filas o dejar fuera la leyenda de un gráfico.
OCR, reconocimiento óptico de caracteres, recupera texto de imágenes, pero puede confundir signos, decimales o unidades. Un modelo con entrada visual puede interpretar la disposición de la página y también equivocarse al asociar un color con una serie. Combinar texto e imagen nos da más evidencia para comprobar la extracción; no convierte el resultado en correcto automáticamente.
La documentación de Docling separa estructura del documento, orden de lectura, tablas y OCR, entre otras capacidades. [1] Es una referencia útil para entender qué información se pierde cuando tratamos todo el documento como una cadena de texto.
| Origen | Evidencia que conservaría | Comprobación necesaria |
|---|---|---|
| Texto | Fragmento original y localización | La frase existe y sostiene la afirmación con su alcance |
| Tabla | Celdas, cabeceras y notas pertinentes | La cifra corresponde a esa fila y columna, con la unidad correcta |
| Gráfico | Página o recorte, título, serie y categoría | El valor pertenece a esa serie; distinguir cifra impresa de estimación visual |
La página es una unidad cómoda para analizar disposición visual. Sin embargo, una tabla puede continuar en la siguiente y la definición de la muestra aparecer antes. Necesitamos recuperar ese contexto sin atribuir indiscriminadamente los metadatos de todo el informe a cada dato.
Algunas de estas decisiones aparecen en Athena, un buscador de datos y estudios del sector de eventos: su pipeline de ingesta combina texto e imagen por página y distingue datos procedentes de texto, tablas y gráficos, conservando la referencia a la fuente y a la página.
Yo aplicaría extracción visual cuando la disposición aporte información que el texto no conserva. En documentos sencillos puede añadir coste sin mejorar el resultado, así que esa decisión también necesita evaluación.
Separar evidencia, afirmación y texto para búsqueda
La evidencia original debe permanecer separada de la afirmación normalizada y de la representación que usamos para buscar. Cada una cumple una función distinta y puede cambiar a un ritmo diferente.
La evidencia permite verificar. La afirmación reúne en una frase autónoma qué se midió, sobre quién y cuándo. El texto para búsqueda puede incluir términos normalizados que ayuden a encontrarla, pero esos términos añadidos no pasan a ser palabras de la fuente.
Los embeddings representan texto mediante números que permiten comparar similitud. pgvector, por ejemplo, ofrece búsqueda por similitud vectorial en PostgreSQL. [2] Esa comparación ayuda a recuperar candidatos; no comprueba que una evidencia respalde una conclusión.
Si buscamos «aumento del gasto en formación», podríamos recuperar nuestro 35 %. El registro tiene que conservar que mide cuántas empresas aumentaron el presupuesto, porque una consulta parecida no cambia el significado del dato.
Extraer hechos estructurados aporta valor cuando queremos responder preguntas sobre cifras. Los fragmentos de texto siguen siendo útiles para explicaciones, metodología o condiciones que no caben en un registro. Podemos recuperar el hecho y añadir el contexto pertinente, en lugar de obligar a toda la documentación a convertirse en cifras.
El coste de normalizar también cuenta: podemos perder matices o guardar una interpretación incorrecta con apariencia de precisión. Por eso comprobaría el registro antes de convertirlo en conocimiento consultable.
¿Qué validamos antes de indexar?
Validar el esquema demuestra que podemos procesar una extracción, no que sea fiel a la fuente. Un JSON con un porcentaje incorrecto puede cumplir todas las reglas de tipos.
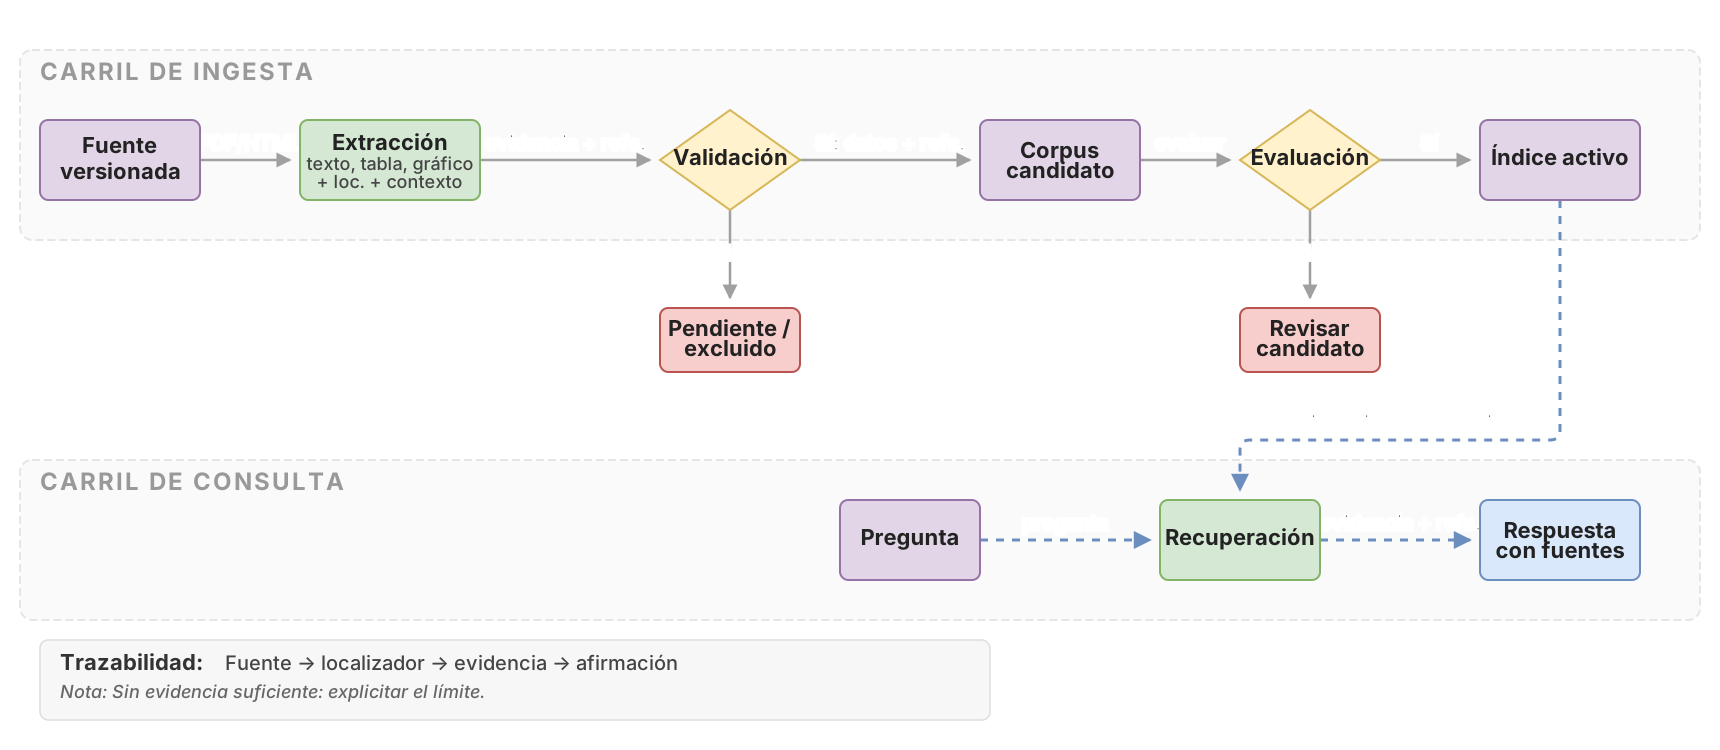
Primero aplicaría comprobaciones deterministas: identificador de fuente existente, página dentro del documento, tipos correctos, unidades admitidas y campos obligatorios. Después comprobaría el respaldo de la afirmación. En nuestro ejemplo, debemos distinguir «el 35 % aumentó el presupuesto» de «el presupuesto aumentó un 35 %».
Para una cita textual, podemos buscar su presencia en el texto extraído. Si normalizamos saltos de línea o guiones de final de línea, hay que mantener esas reglas acotadas y conservar el original. Cuanto más tolerante sea la comparación, más cuidado necesitamos para no aceptar coincidencias engañosas.
Una cita encontrada todavía puede respaldar una afirmación distinta. La presencia es una comprobación útil, pero el sujeto, la unidad y el periodo necesitan revisión semántica.
En un gráfico sin frase equivalente, la cita literal puede ser null y la evidencia seguir siendo verificable. La referencia debe llevar a la página y al gráfico pertinente. Si solo estimamos una altura, el dato debe marcarse como aproximado o excluirse cuando la aplicación requiera cifras exactas.
Una auditoría con LLM puede detectar errores que las reglas no ven, aunque también falla. La usaría como una capa complementaria, con ejemplos revisados por personas, y conservaría las razones de rechazo. Para datos especialmente sensibles, el umbral de revisión debe responder al coste de equivocarse.
Reanudar cargas y controlar el coste
Una ingesta eficiente reutiliza trabajo válido y repite únicamente las unidades que necesitan procesarse. Para conseguirlo necesitamos persistencia, estados claros y versiones de los artefactos.
Deduplicar por hash de los bytes detecta archivos idénticos. Si cambia la compresión del PDF, los bytes pueden cambiar aunque el contenido sea equivalente, así que una comparación por contenido añade otra capa. Hay que definir su alcance: dos ediciones con párrafos repetidos pueden contener cifras distintas y no deberían fusionarse sin más.
También necesitamos separar duplicación de corroboración. La misma cifra copiada en varios documentos no demuestra que existan varias mediciones independientes.
Persistiría el resultado por página o unidad de extracción, con estados que distingan una página procesada sin datos de una llamada fallida. Una portada puede devolver cero hechos correctamente; un error del proveedor no puede convertirse en una extracción vacía aceptada.
La clave de reutilización debería incluir la versión del documento y las versiones del extractor, prompt, modelo y esquema. Si corregimos el prompt porque confundía porcentajes con variaciones, reutilizar sus extracciones anteriores conservaría el fallo. Cambiar solo la representación para búsqueda, en cambio, puede permitir recalcular embeddings sin volver a extraer el PDF.
La concurrencia limitada permite procesar varias páginas sin lanzar todas las llamadas a la vez. Añadiría reintentos acotados para fallos transitorios y límites de gasto y tiempo. Registrar costes por fase ayuda a decidir si estamos pagando por extracción útil o por repetir errores; acelerar llamadas que luego rechazamos mejora poco el sistema.
Evaluar un corpus candidato antes de activarlo
Una nueva ingesta debe probarse en un corpus candidato separado del que utiliza el buscador. Así podemos comparar versiones y detectar regresiones antes de cambiar las respuestas de los usuarios.
Prepararía un conjunto revisado por personas con prosa, tablas, gráficos, documentos difíciles y preguntas sin respuesta. Para nuestro informe ficticio incluiría tanto «¿qué proporción de empresas aumentó el presupuesto?» como «¿cuánto aumentó el presupuesto?». La primera tiene respuesta en la frase; la segunda no.
Mediría por separado:
- Extracción: datos correctamente representados, contexto perdido y errores materiales, desglosados por origen.
- Cobertura: evidencia relevante que el extractor dejó fuera. Contar solo los datos aceptados oculta esas omisiones.
- Recuperación: si aparece la evidencia necesaria entre los resultados y si se mantiene su contexto.
- Respuesta: afirmaciones respaldadas, referencias correctas y límites cuando faltan datos.
Añadiría coste por dato aceptado y duración de la ingesta. Una extracción barata que exige muchas correcciones puede salir peor que otra más cara; también necesitamos saber cuánto conocimiento útil estamos descartando.
Las respuestas esperadas pertenecen al evaluador, no al índice consultado. Si las introducimos en el material recuperable, podemos aprobar una prueba sin demostrar que el sistema entiende las fuentes.
Separaría los fallos de infraestructura de los errores de contenido. Un timeout explica por qué falta una página, pero no equivale a una interpretación incorrecta. Activaría el candidato tras superar los controles definidos y conservaría la versión anterior para poder revertir una regresión.
La respuesta todavía necesita controles
La generación debe limitar sus afirmaciones a la evidencia recuperada y resolver las referencias desde identificadores existentes. El modelo puede indicar qué dato usa; la aplicación debe comprobar que existe y construir su enlace, evitando que invente una URL.
Después hay que comprobar el respaldo. El registro del 35 % sostiene una respuesta sobre la proporción de empresas, pero no permite calcular cuánto aumentó su presupuesto. Tampoco podemos generalizarlo a empresas pequeñas ni eliminar el periodo para presentarlo como situación actual.
Si hay contradicciones, conviene mostrarlas con su alcance en vez de fabricar una cifra única. Si falta evidencia, podemos explicarlo y pedir una consulta más acotada. Un segundo LLM que revise la respuesta es una opción, con coste y errores propios, no una garantía de ausencia de alucinaciones.
Yo empezaría optimizando esta cadena con un corpus pequeño y preguntas que obliguen a conservar el contexto. Si seguimos devolviendo «el presupuesto aumentó un 35 %», añadir más documentos solo amplía el trabajo pendiente. Primero tenemos que mantener el significado de un dato desde su página hasta la respuesta.
Fuentes
- Documentación de Docling: procesamiento de documentos, estructura, orden de lectura, tablas y OCR.
- Documentación de pgvector: búsqueda por similitud vectorial en PostgreSQL.
Preguntas Frecuentes
¿RAG elimina las alucinaciones?
No. Recuperar evidencia reduce algunas causas de error, pero el extractor puede interpretarla mal, el buscador omitir contexto y el modelo generar una conclusión sin respaldo.
¿Una referencia demuestra que la respuesta es correcta?
Demuestra dónde comprobarla, siempre que la referencia exista y sea accesible. La afirmación todavía debe estar respaldada por esa evidencia y respetar su población, periodo y unidad.
¿Conviene indexar hechos o fragmentos?
Depende de las consultas. Para cifras, los hechos estructurados permiten conservar el significado de cada valor; para explicaciones y metodología, los fragmentos mantienen contexto que un esquema puede dejar fuera.
Podemos combinar ambos y evaluar si recuperar contexto adicional mejora las respuestas o solo añade tokens.
¿Cómo citamos un dato de un gráfico sin inventar una frase?
Con una referencia al documento, la página y el gráfico, conservando la evidencia visual y los elementos que identifican el dato. La cita literal puede quedar vacía.