Qué es Docling y cómo prepara documentos para RAG
Qué es Docling, cómo convierte documentos en estructura y dónde encaja en RAG. Un ejemplo Python y criterios para evaluar texto, tablas y fuentes.
¿Has copiado una tabla de un PDF y te han aparecido las cifras separadas de sus cabeceras? El documento se ve bien, pero el texto que recibe nuestra aplicación puede haber perdido lo que cada número significa. Docling ayuda a convertir ese documento en contenido organizado, con una estructura que podemos inspeccionar antes de usarla en un buscador.
Para seguir el ejemplo basta con entender archivos y funciones; el código utiliza Python. Yo empezaría por esta distinción: leer las palabras de un documento y reconstruir sus relaciones son tareas diferentes. Una tabla necesita conservar qué cifra pertenece a cada fila y columna.
¿Qué es Docling?
Docling es un conjunto de herramientas de código abierto que convierte documentos a una representación estructurada. Admite varios formatos, como PDF, DOCX y HTML, y ofrece funciones para interpretar disposición de página, tablas y texto de documentos escaneados. Las capacidades concretas dependen del formato y de la configuración elegida. [1]
Imaginemos un informe ficticio con esta tabla:
| Tamaño de empresa | Empresas que aumentaron el presupuesto de formación |
|---|---|
| Hasta 500 empleados | 18 % |
| Más de 500 empleados | 35 % |
Debajo aparece la nota «Datos correspondientes a 2025». Si guardamos únicamente 18 % 35 %, la extracción contiene las cifras, pero hemos perdido la variable y la población. Tampoco sabemos el periodo. Necesitamos reconstruir suficiente estructura para poder comprobar qué dice realmente el informe.
Por qué un PDF necesita algo más que extracción de texto
La disposición visual de un PDF comunica relaciones que una extracción de texto puede perder. Una cabecera situada encima de dos columnas, una nota pequeña o el orden entre bloques pueden cambiar cómo interpretamos una cifra.
El análisis de estructura, también llamado parsing, identifica elementos y relaciones a partir del archivo. En un PDF con texto digital podemos recuperar caracteres, pero sigue haciendo falta determinar su orden y cómo se agrupan. En una página escaneada, en cambio, las palabras son parte de una imagen.
OCR, reconocimiento óptico de caracteres, transforma esas imágenes en texto. Docling dispone de motores de OCR configurables para esa etapa. [2] Reconocer correctamente «35 %» todavía no demuestra que esa cifra pertenezca a la fila de empresas grandes: necesitamos revisar la tabla además de los caracteres.
Yo separaría ambas comprobaciones. Primero, ¿hemos leído lo que aparece en la página? Después, ¿hemos conservado la relación entre la cifra, su cabecera y su nota? Esa separación permite corregir un signo mal leído sin confundirlo con un error de estructura.
La salida central: DoclingDocument
DoclingDocument es la representación común del documento convertido: organiza contenido, jerarquía y procedencia cuando está disponible. Incluye elementos como texto, tablas e imágenes, con relaciones entre ellos y separación entre cuerpo principal y elementos como cabeceras o pies de página. [3]
La procedencia indica de dónde sale un elemento. En un PDF puede incluir página y región, es decir, la zona rectangular donde se localizó. Esa información nos ayuda a volver del contenido extraído al original, aunque no todos los formatos ni todas las conversiones proporcionan el mismo detalle.
Markdown es cómodo para leer el resultado: expresa títulos, párrafos y tablas con una sintaxis de texto sencilla. JSON permite guardar la representación estructurada para procesarla con código. Docling ofrece esas exportaciones, entre otras. [1] Una tabla Markdown legible puede ocultar que hemos descartado información de localización; por eso elegiría la salida según lo que necesite comprobar después.
Para nuestro informe conservaría el archivo original y una exportación estructurada. Añadiría un identificador estable y una versión del archivo desde la aplicación: así podemos distinguir dos ediciones aunque tengan el mismo nombre. Es una decisión de nuestra ingesta, no una propiedad que debamos asumir que el convertidor resuelve por nosotros.
Convertir un archivo local con Python
DocumentConverter convierte una ruta de archivo o una URL y devuelve un resultado que contiene el documento convertido. El ejemplo básico de la documentación utiliza su atributo document y el método export_to_markdown(). [4]
En un entorno Python con Docling instalado, este ejemplo lee un informe.pdf situado en el directorio de trabajo:
from docling.document_converter import DocumentConverter  # Importa el convertidor.

converter = DocumentConverter()  # Usa la configuración predeterminada.
result = converter.convert("informe.pdf")  # Convierte el archivo local.
document = result.document  # Obtiene su representación estructurada.
print(document.export_to_markdown())  # Muestra una exportación legible.
structured = document.export_to_dict()  # Obtiene un diccionario para procesarlo.
structured contiene la representación exportada como diccionario, no un registro de negocio con un campo «porcentaje de empresas». export_to_dict() es un método de DoclingDocument; esa extracción específica requiere lógica posterior. [5]
La primera ejecución puede descargar modelos. Para trabajar sin conexión hay que prepararlos previamente y configurar su ubicación. Docling también permite etapas con servicios remotos, que requieren habilitación explícita y pueden enviar contenido fuera del equipo. [2] Ejecutar una conversión local y contratar una API remota son decisiones distintas sobre dónde se procesan los documentos.
De un documento estructurado a los hechos
Extraer hechos significa convertir evidencia en afirmaciones con campos que podamos consultar y comprobar. Es un paso adicional a reconocer una tabla o exportar el documento a JSON: necesitamos interpretar qué representa cada celda.
Para nuestro ejemplo, el hecho reúne una variable, «empresas que aumentaron el presupuesto de formación»; el valor 35; la unidad «porcentaje»; la población «más de 500 empleados»; y el periodo 2025. Guardaría también la evidencia y su localización. Así evitamos confundir el porcentaje de empresas con el porcentaje de aumento del presupuesto.
Podemos construir esa extracción con reglas o con un modelo, según los documentos. En ambos casos hay que verificar que los campos estén respaldados por la fuente y dejar como desconocido lo que no aparece. La conversión básica de Docling no entrega automáticamente ese contrato de negocio: la estructura facilita prepararlo, pero la afirmación todavía necesita validación.
Dónde encaja Docling en RAG
RAG, retrieval-augmented generation, combina recuperación de información y generación de una respuesta: buscamos evidencia y se la entregamos a un modelo de lenguaje. Docling puede preparar los documentos que consultaremos, pero la conversión por sí sola no crea el buscador ni responde preguntas.
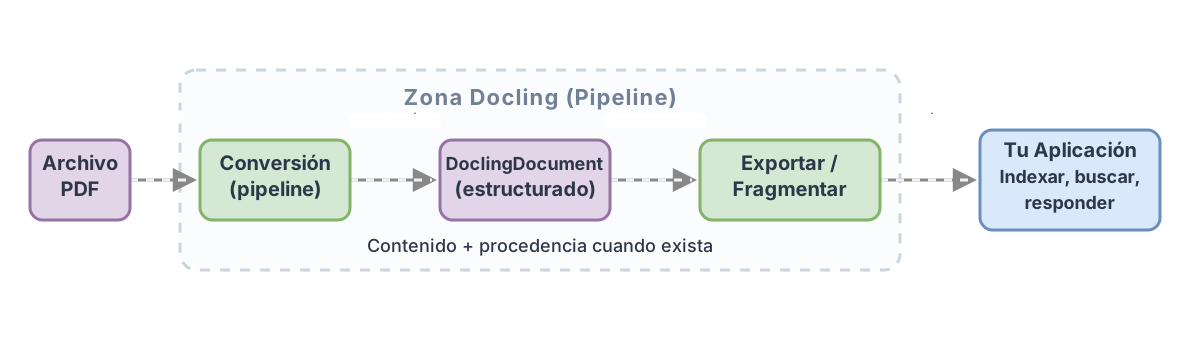
Tras convertir, solemos dividir el documento en fragmentos. Esta fragmentación, o chunking, permite buscar partes manejables en vez de entregar un informe entero en cada consulta. El problema es decidir qué puede separarse sin perder significado.
Si cortamos nuestra tabla por longitud, podríamos dejar el 35 % en un fragmento y la cabecera en otro. Yo comprobaría que el texto preparado para búsqueda conserve la variable y la población, y mantendría una referencia al elemento de origen. La nota del periodo puede requerir una asociación adicional; no conviene dar por hecho que cualquier fragmentador entenderá su alcance.
Docling permite fragmentar el DoclingDocument directamente. HybridChunker combina estructura documental con límites medidos mediante un tokenizer, el componente que divide texto en las unidades que procesa un modelo. Su configuración debe tener en cuenta el modelo que consumirá los fragmentos. [6]
Después podemos calcular embeddings, representaciones numéricas del texto que ayudan a comparar similitud, y guardarlos en un índice de búsqueda. La aplicación recupera candidatos y decide qué evidencia recibe el modelo que responde. También tiene que conservar los localizadores y construir las referencias.
La ingeniería de ingesta para RAG desarrolla esos controles: validar la extracción, mantener contexto y evaluar antes de activar una nueva versión del corpus. Docling ocupa una etapa de esa cadena; los errores posteriores necesitan controles propios.
Cómo decidir si encaja en nuestros documentos
Yo evaluaría Docling comparando sus resultados con páginas concretas del material que vamos a procesar. Un ejemplo sencillo demuestra cómo se usa la API, pero no representa necesariamente nuestros informes.
Prepararía una muestra con documentos de dos columnas, tablas con celdas combinadas, notas y páginas escaneadas. Para cada caso guardaría lo esperado y revisaría tanto errores como omisiones. En la tabla ficticia, aceptar una cifra exige conservar su fila, la variable y el periodo.
| Necesidad | Qué comprobaría |
|---|---|
| Leer documentación sencilla | Que una extracción más simple no resuelva ya el problema con menos coste |
| Recuperar tablas de informes | Cabeceras, filas, unidades y notas pertinentes |
| Procesar documentos escaneados | Texto reconocido, signos y orden de lectura |
| Citar evidencia | Que la aplicación mantenga el enlace al archivo y los localizadores disponibles |
Los gráficos merecen una prueba aparte. Reconocer una imagen o generar una descripción no demuestra que sus valores se hayan extraído correctamente. Si queremos cifras exactas, debemos comprobarlas contra el gráfico y distinguirlas de estimaciones visuales.
Mediría también duración y recursos con nuestro entorno. Si cambiamos de pipeline o modelo, volvería a comparar la muestra: una mejora en páginas escaneadas puede introducir errores en tablas que antes funcionaban. El código de Docling tiene licencia MIT, mientras que los modelos tienen sus propias licencias. [1]
Mi criterio de aceptación sería concreto: podemos volver al original y verificar lo que la aplicación afirma. Si una conversión produce texto limpio pero separa el 35 % de su población, todavía no tenemos una base fiable para responder.
Fuentes
- Repositorio oficial de Docling: definición, capacidades, exportaciones y licencias.
- Opciones avanzadas de Docling: configuración de OCR, modelos locales y servicios remotos.
- Modelo DoclingDocument: contenido, jerarquía y procedencia.
- Inicio rápido de Docling: uso de
DocumentConvertery exportación Markdown. - Referencia de DoclingDocument: método
export_to_dict(). - Fragmentación en Docling: fragmentos sobre el documento estructurado y
HybridChunker.
Preguntas Frecuentes
¿Docling es un modelo de lenguaje?
Docling es un conjunto de herramientas de procesamiento documental. Puede utilizar modelos en etapas concretas, pero elegir Docling no equivale a elegir un único modelo de lenguaje.
¿Docling puede procesar un PDF escaneado?
Sí, dispone de OCR para recuperar texto de páginas escaneadas. El motor y su configuración afectan al resultado, y hay que revisar signos, cifras y estructura en documentos representativos.
¿Convertir un PDF con Docling evita las alucinaciones?
No. Una conversión conserva información que puede ayudar a fundamentar respuestas, pero todavía puede contener errores. Además necesitamos comprobar extracción, recuperación y respaldo de las afirmaciones generadas.
¿Debo guardar Markdown o JSON?
Markdown facilita leer el contenido convertido. Si necesitamos inspeccionar elementos y conservar la representación estructurada, JSON resulta más apropiado. Podemos guardar ambos y mantener también el original para comprobar la extracción.