
RAG vs grounding: en qué se diferencian y cuándo se solapan
Grounding es que la respuesta de la IA se apoye en fuentes comprobables; RAG es una forma de conseguirlo. La diferencia, con ejemplos, y dónde se cruzan.
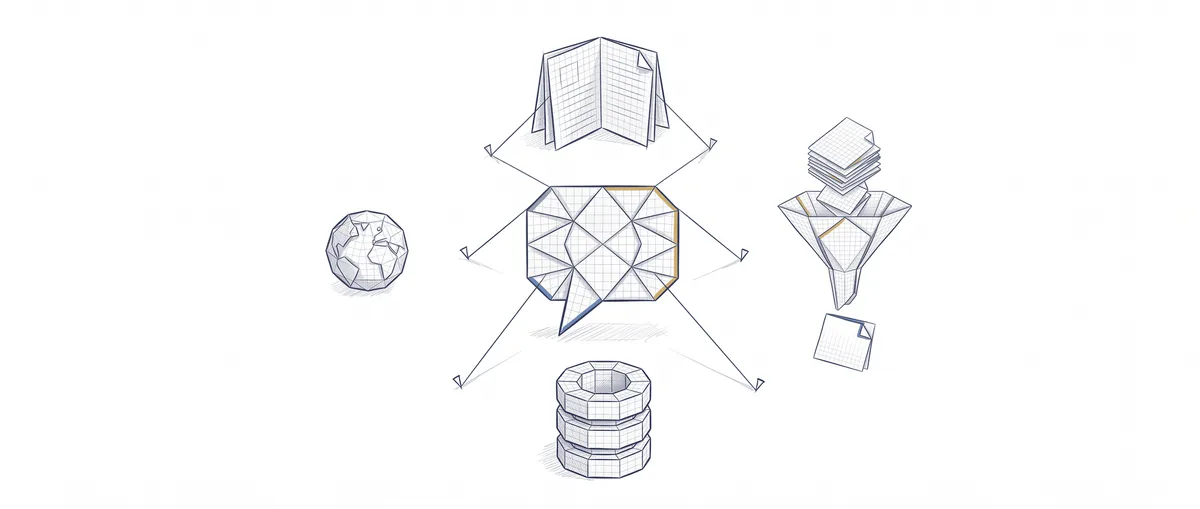
Grounding es el objetivo: que la respuesta de un modelo de lenguaje se apoye en fuentes que puedes comprobar y no solo en lo que memorizó al entrenarse. RAG es una técnica para conseguirlo, la más habitual. Todo RAG busca grounding, pero hay grounding sin RAG, y RAG que no acaba anclado.
La confusión es normal, porque las dos palabras aparecen en la misma frase de cualquier documentación y parecen sinónimos. No lo son, y no compiten entre sí: una es el qué y la otra es un cómo. Para seguir el post solo te hace falta saber qué es una alucinación, cuando el modelo inventa con total seguridad, porque las dos cosas existen para combatirla.
Grounding vs RAG, lado a lado
| Grounding | RAG | |
|---|---|---|
| Qué es | Un objetivo: una propiedad que tiene (o no) la respuesta | Una técnica concreta, descrita por Lewis et al. en NeurIPS 2020 [1] |
| Qué pregunta responde | ¿En qué se apoya esto que dice el modelo? | ¿Cómo consigo el texto que el modelo necesita para responder? |
| De dónde sale la información | De cualquier fuente verificable: tus documentos, la web, una base de datos, un mapa | De un índice sobre tu colección de documentos |
| Cómo se nota | Cada afirmación se puede rastrear hasta una fuente | En el prompt (el texto que le mandas al modelo) entran fragmentos recuperados antes de la pregunta |
| Ejemplos con nombre | Grounding with Google Search, Citations de Claude | Un buscador sobre tus documentos que se ejecuta antes de llamar al modelo |
Si solo te quedas con una fila, que sea la primera. Grounding describe el resultado y RAG describe un mecanismo.
Qué significa grounding en IA
Grounding significa anclar la salida del modelo a fuentes de información verificables. En español lo verás traducido como anclaje o fundamentación, pero en la práctica casi todo el mundo dice grounding, igual que decimos prompt. Google lo define en su documentación de Vertex AI como la capacidad de conectar la salida del modelo con fuentes verificables, y lo vende precisamente como forma de reducir alucinaciones y de poder auditar de dónde sale cada dato [2].
Piensa en la diferencia entre un examen de memoria y uno a libro abierto en el que además tienes que poner la página de donde sacas cada respuesta. El alumno es el mismo. Lo que cambia es que ahora puedes comprobar lo que dice.
Lo interesante es que, en esa misma documentación, Google lista varias maneras de conseguir grounding: con Google Search, con Google Maps, con tus propios datos, con tu propio buscador, y una de ellas se llama literalmente “Grounding responses using RAG” [2]. RAG aparece como una opción dentro de la lista. Esa es la relación exacta entre las dos palabras.
Grounding sin RAG: ejemplos
Hay grounding cada vez que el modelo responde con una fuente delante que se puede verificar, la haya buscado un índice propio o no. Estos cuatro casos no montan ningún RAG tuyo:
Pegar el documento en la conversación. Le pasas el contrato entero y le preguntas por la cláusula de rescisión. No hay búsqueda ni índice, y aun así la respuesta está anclada a un texto concreto. Si el documento cabe en la ventana de contexto, el máximo de texto que el modelo puede leer de una vez, muchas veces es lo más sensato.
Búsqueda web con citas. Con Grounding with Google Search, Gemini decide por su cuenta si le hace falta buscar y, cuando busca, devuelve un bloque groundingMetadata con las consultas que hizo, las páginas usadas y qué trozo de la respuesta se apoya en cada una [3]. La herramienta de búsqueda web de OpenAI hace algo parecido con anotaciones url_citation que llevan la URL y la posición en el texto [4]. Técnicamente eso también es recuperar y aumentar, y hay quien lo llama RAG sobre la web; la diferencia práctica es que el índice no lo montas ni lo mantienes tú.
Consultar un dato en vivo. Si el modelo llama a una herramienta (una función de tu código que el modelo puede pedir que se ejecute) que lee el estado de un pedido en tu base de datos, la respuesta se apoya en ese valor, no en su memoria. Ahí no hay documentos que trocear. La diferencia entre traer texto indexado y consultar sistemas en vivo la desarrollo en MCP vs RAG.
Citas sobre documentos que ya le das. La función Citations de la API de Claude no busca nada: tú le pasas los documentos (texto plano, PDF o contenido propio) y la respuesta vuelve con el cited_text exacto y su ubicación, sea un rango de caracteres o de páginas [5]. Es una capa de verificación, y encaja igual de bien encima de un RAG que sin él.
¿Y el fine-tuning? Aquí suele colarse en las listas, y no encaja. Entrenar el modelo con más ejemplos cambia lo que sabe, pero la respuesta sigue saliendo de lo que el modelo aprendió al entrenarse: no hay ninguna fuente que el lector pueda abrir para comprobarla.
RAG que no acaba anclado: dónde se solapan y dónde no
Se solapan en la intención, y se separan en el resultado. Hacer RAG significa que el modelo tiene los fragmentos delante; grounding significa que lo que responde está respaldado por ellos, y lo primero no garantiza lo segundo. Si la búsqueda trae el fragmento equivocado, el modelo redacta con aplomo una respuesta anclada al texto incorrecto. Y si el fragmento es bueno pero incompleto, a veces rellena el hueco con lo que recuerda del entrenamiento, que es justo lo que querías evitar. El funcionamiento por dentro de la recuperación lo tienes en qué es RAG y cómo funciona paso a paso.
Por eso, cuando montamos un RAG, lo que de verdad nos interesa medir es el grounding. Un control barato es pedir al modelo que cite el fragmento en el que se apoya cada frase y comprobar que esas citas existen:
// fragmentos: lo que devolvió tu búsqueda, cada uno con un id
const prompt = `Responde SOLO con estos fragmentos.
Tras cada frase, escribe entre corchetes el id del fragmento que la respalda.
${fragmentos.map((f) => `[${f.id}] ${f.texto}`).join("\n")}
Pregunta: ${pregunta}`;

const respuesta = await modelo.completar(prompt);

// Sacamos todos los ids que el modelo ha citado
const citados = [...respuesta.matchAll(/\[(\w+)\]/g)].map((m) => m[1]);
// Anclada = cita algo, y todo lo que cita existe de verdad
const ids = new Set(fragmentos.map((f) => f.id));
const anclada = citados.length > 0 && citados.every((id) => ids.has(id));
Este control detecta citas inventadas o respuestas sin ninguna cita, que ya es mucho. Lo que no detecta es una cita real pegada a una frase que el fragmento no dice. Esa comprobación es más cara, porque alguien, sea una persona u otro modelo, tiene que leer las dos cosas y compararlas.
Así que la pregunta útil ante un sistema nuevo nunca es “¿usa RAG?”, sino “¿puedo comprobar de dónde sale cada respuesta?”. Si quieres ver cómo encajan RAG, las herramientas y estas verificaciones dentro de un agente completo, el curso Patrones de Diseño para Agentes de IA lo recorre con ejercicios interactivos.
Fuentes
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., NeurIPS 2020): artículo original que describe RAG.
- Grounding overview (Google Cloud, Vertex AI): definición de grounding y lista de métodos, incluido “Grounding responses using RAG”.
- Grounding with Google Search (Google, Firebase AI Logic): búsqueda web como grounding y contenido de
groundingMetadata. - Web search (OpenAI API): herramienta de búsqueda web con anotaciones
url_citation. - Citations (Claude Platform Docs): citas sobre documentos que proporciona el usuario, con
cited_texty ubicación.
Preguntas Frecuentes
¿Qué es grounding en IA, en una frase?
Es conseguir que la respuesta de un modelo de lenguaje se apoye en fuentes verificables que recibe al responder, y no solo en lo que aprendió durante el entrenamiento.
¿Cuál es la diferencia entre grounding y RAG?
Grounding es el objetivo y RAG es una de las técnicas para alcanzarlo. RAG busca fragmentos en tus documentos y los mete en el prompt; grounding es la propiedad de que la respuesta final esté respaldada por una fuente comprobable, venga esa fuente de RAG o de cualquier otro sitio, como una búsqueda web.
¿Un sistema con RAG tiene grounding automáticamente?
No. Tener los fragmentos en el prompt no obliga al modelo a ceñirse a ellos. Si la recuperación falla o el modelo completa con su memoria, la respuesta puede sonar igual de segura y no estar respaldada por nada de lo que le diste. Hay que medirlo, por ejemplo exigiendo citas y comprobándolas.
¿El grounding elimina las alucinaciones?
Las reduce, que es para lo que existe, pero no las elimina. Su ventaja real es otra: cuando el modelo se equivoca, puedes ir a la fuente y ver el error, en lugar de tener que creerle.
¿Tengo que montar un RAG para tener grounding?
Solo si tu información es privada, abundante y no cabe en una conversación. Para un puñado de documentos basta con pegarlos, y para información pública y reciente una búsqueda web con citas suele hacer el trabajo sin que mantengas ningún índice.
Artículos relacionados
Qué es RAG en IA: definición simple y para qué sirve
RAG es buscar tus documentos y dárselos al modelo antes de que responda. Qué es, qué problema resuelve, cómo funciona y cuándo no merece la pena.
Qué es una alucinación de la IA y por qué es inevitable
Qué es una alucinación de la IA, por qué nace del propio mecanismo del modelo y qué implica para tu negocio antes de confiarle una tarea.
MCP vs RAG: diferencias y cómo funcionan juntos
MCP conecta el modelo con herramientas y datos en vivo. RAG le mete texto relevante en el prompt. No compiten: aquí está la diferencia y cuándo usar los dos.